Un audit technique SEO vérifie que Google peut explorer, afficher et indexer les pages importantes de votre site, puis repère ce qui freine leur classement : erreurs, redirections, lenteur, balisage. La checklist ci-dessous suit l’ordre logique de l’audit, de l’indexation aux données structurées, avec un outil gratuit pour chaque contrôle.
À retenir
- L’indexation se contrôle en premier, car une page absente de l’index ne peut pas se classer, quelle que soit sa qualité.
- Google pose trois conditions minimales : Googlebot n’est pas bloqué, la page renvoie un code HTTP 200 et son contenu est indexable.
- Le robots.txt ne désindexe pas une page. Pour la retirer de Google, utilisez la balise
noindex. - Les seuils Core Web Vitals à viser sont LCP ≤ 2,5 s, INP ≤ 200 ms et CLS ≤ 0,1.
- Trois outils gratuits suffisent pour un premier audit : la Search Console, Screaming Frog (jusqu’à 500 URL) et PageSpeed Insights.
Avec cette checklist, vous pouvez faire un premier diagnostic vous-même. Pour un site de plusieurs centaines de pages, une refonte ou une migration, je réalise aussi un audit technique SEO complet, remis avec un plan de corrections classé par priorité.
Au sommaire
- Audit technique SEO : l’ordre des contrôles
- Outils gratuits pour réaliser un audit technique SEO
- Indexation : les contrôles dans la Search Console
- Exploration et robots.txt : vérifier l’accès de Googlebot
- Codes HTTP et redirections : la checklist du crawl
- Balises canoniques et sitemap XML : aider Google à choisir les bonnes URL
- Core Web Vitals : les seuils de vitesse à viser
- Version mobile et HTTPS : les contrôles d’expérience sur la page
- Données structurées : contrôler le balisage sans prendre de risque
- Balises et maillage interne : les contrôles on-page du crawl
- Prioriser les corrections après l’audit technique
- Questions fréquentes sur l’audit technique SEO
Audit technique SEO : l’ordre des contrôles
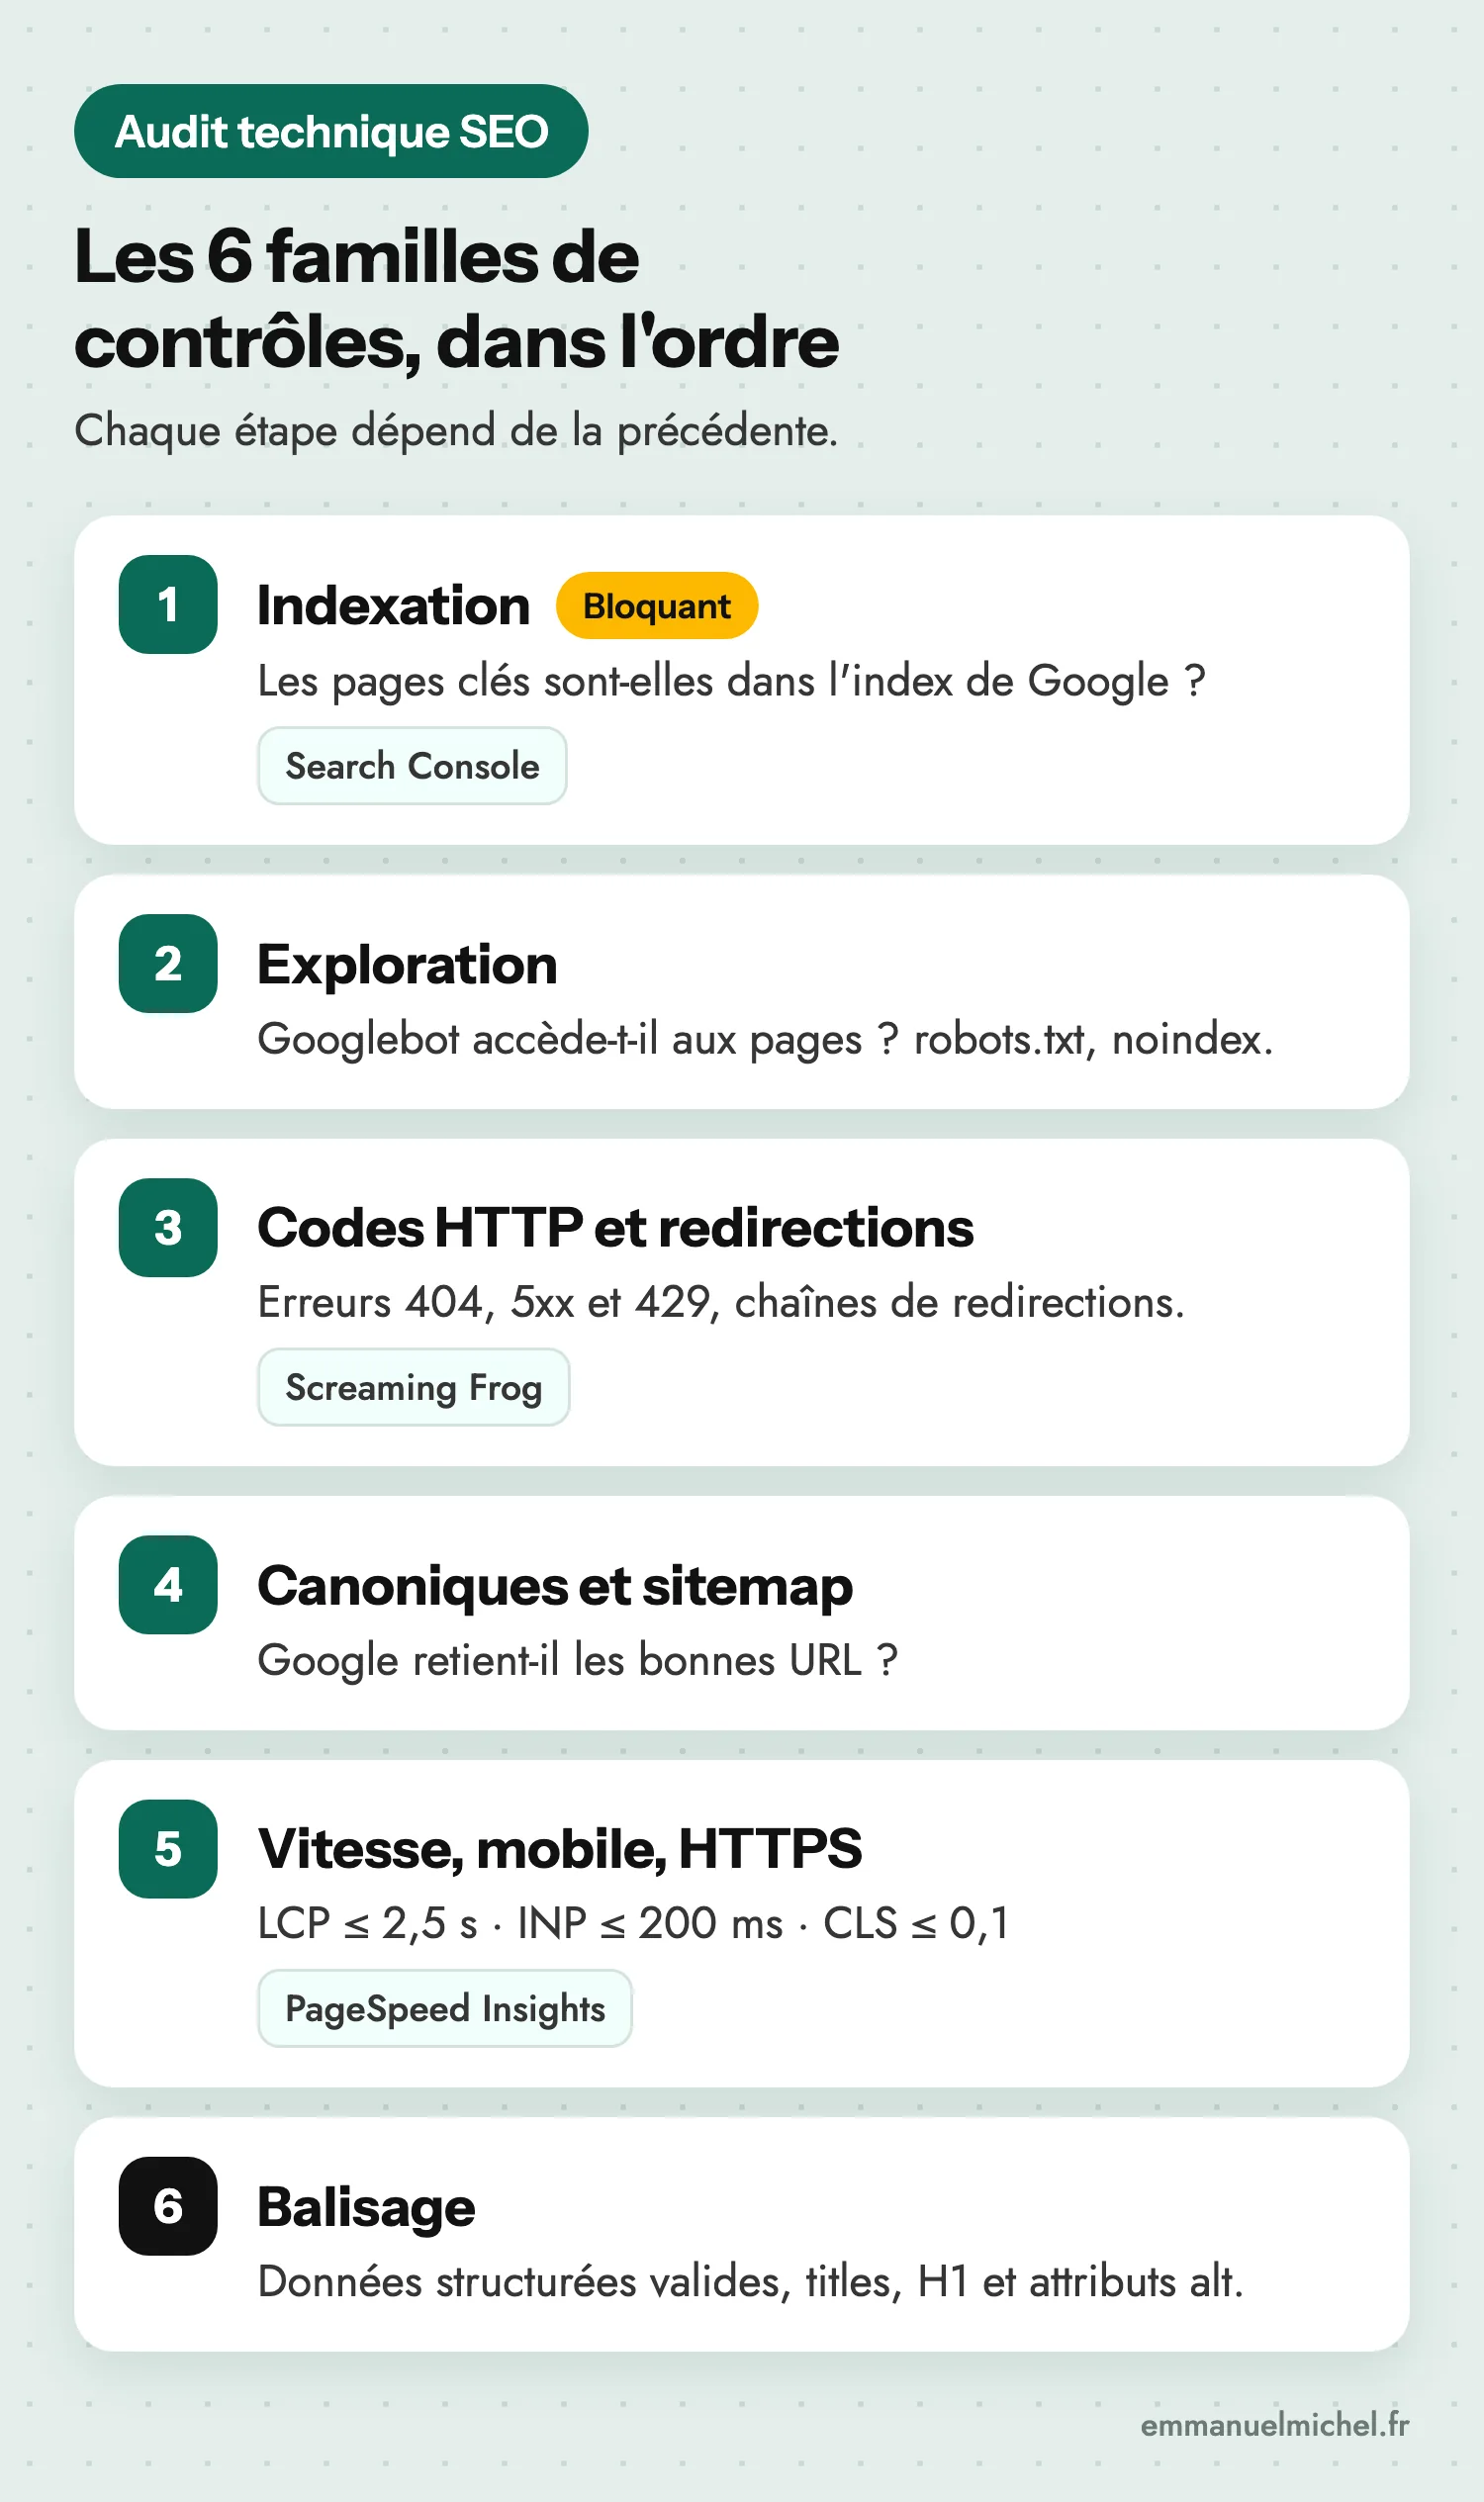
Un audit technique se mène dans un ordre précis, parce que chaque étape dépend de la précédente : inutile d’accélérer une page que Google n’indexe pas. Google fixe trois exigences minimales pour qu’une page soit éligible à l’indexation, dans sa page sur les exigences techniques de la recherche Google :
- Googlebot n’est pas bloqué ;
- la page fonctionne, c’est-à-dire qu’elle renvoie un code HTTP 200 ;
- la page a un contenu indexable.
Google précise que respecter ces trois conditions ne garantit pas l’indexation. Elles restent le point de départ. Ensuite, les contrôles se regroupent en six familles, à traiter dans cet ordre :
- Indexation : les pages clés sont-elles dans l’index ?
- Exploration : Googlebot accède-t-il aux pages (robots.txt,
noindex) ? - Codes HTTP et redirections : les pages répondent-elles correctement ?
- Canoniques et sitemap : Google retient-il les bonnes URL ?
- Vitesse, mobile et HTTPS : l’expérience sur la page est-elle bonne ?
- Balisage : données structurées, titles, H1 et attributs alt sont-ils valides ?
Outils gratuits pour réaliser un audit technique SEO
Un premier audit se fait avec des outils gratuits. Chacun couvre une partie de la checklist :
| Outil | Ce qu’il contrôle | Prix |
|---|---|---|
| Google Search Console | Indexation, robots.txt, sitemaps, Core Web Vitals, données structurées | Gratuit |
| Inspection d’URL (dans la Search Console) | État d’une URL précise, canonique retenue par Google | Gratuit |
| Screaming Frog SEO Spider | Crawl du site : codes HTTP, redirections, canoniques, balises, profondeur | Gratuit jusqu’à 500 URL, puis 199 £ par an |
| PageSpeed Insights | Core Web Vitals d’une page : données réelles et test de laboratoire | Gratuit |
| Test des résultats enrichis | Validité des données structurées d’une page | Gratuit |
Tarif de Screaming Frog relevé en novembre 2026 sur la page tarifs de l’éditeur. Si la Search Console n’est pas encore en place, commencez par là : voici comment installer la Search Console sur WordPress avec Site Kit. Côté crawl, la version 25 de Screaming Frog ralentit seule quand le serveur sature, une fonction détaillée dans mon article sur les nouveautés de Screaming Frog 25.
Attention : un crawl trop rapide peut saturer un petit hébergement, qui répond alors par des erreurs 429 et fausse l’audit. Les réglages pour l’éviter sont dans mon guide sur l’erreur 429 avec Screaming Frog.
Indexation : les contrôles dans la Search Console
Le rapport « Indexation des pages » de la Search Console liste les URL indexées et la raison pour laquelle les autres ne le sont pas. L’aide du rapport le rappelle : ne vous attendez pas à ce que toutes les URL de votre site soient indexées. Les doublons et les versions alternatives n’ont pas à l’être. L’objectif est que vos pages clés le soient.
| Contrôle | Où regarder | Quand s’inquiéter |
|---|---|---|
| Pages clés indexées | Inspection d’URL : accueil, pages de service, pages qui vendent | Une page stratégique non indexée |
| « Explorée, actuellement non indexée » | Rapport Indexation des pages | Des pages importantes dans la liste |
| « Détectée, actuellement non indexée » | Rapport Indexation des pages | Une grande partie des URL du site |
| « URL marquée “noindex” » | Rapport Indexation des pages | Une page qui devrait se classer |
| « Page en double sans URL canonique sélectionnée par l’utilisateur » | Rapport Indexation des pages | Des pages uniques traitées comme des doublons |
| « Erreur “soft 404” » | Rapport Indexation des pages | Des pages qui ont un vrai contenu |
| Sitemap lu sans erreur | Rapport Sitemaps | Un sitemap en erreur ou non lu |
Comparez le nombre de pages indexées au nombre de pages que vous voulez voir dans Google. Un écart dans un sens (pages manquantes) ou dans l’autre (pages parasites indexées) donne la première piste de l’audit.
Exploration et robots.txt : vérifier l’accès de Googlebot
Le fichier robots.txt indique aux robots les parties du site qu’ils peuvent explorer. Une ligne Disallow: / oubliée après une mise en ligne suffit à bloquer l’exploration de tout le site. Contrôlez trois points :
- le fichier répond à l’adresse
votresite.fr/robots.txtet le rapport robots.txt de la Search Console ne signale pas d’erreur ; - aucune règle ne bloque des pages à indexer, ni les fichiers CSS et JavaScript dont les pages ont besoin pour s’afficher ;
- le sitemap est déclaré dans le fichier avec une ligne
Sitemap:.
Le robots.txt ne retire pas une page de Google. La documentation de Google sur le fichier robots.txt le précise : une URL bloquée peut quand même être indexée si d’autres pages pointent vers elle. Pour désindexer une page, laissez-la explorable et ajoutez une balise noindex : si la page est bloquée par le robots.txt, Google ne lira jamais cette balise.
Le budget de crawl, souvent cité dans les audits, concerne surtout les gros sites. Le guide de Google sur le budget de crawl vise les sites de plus d’un million de pages dont le contenu change chaque semaine, ou de plus de 10 000 pages dont le contenu change chaque jour (une estimation approximative, précise Google). Pour un site vitrine de quelques dizaines de pages, ce n’est pas une priorité.
Codes HTTP et redirections : la checklist du crawl
Lancez un crawl complet du site, puis vérifiez chaque famille de codes de réponse. La documentation de Google sur les codes d’état HTTP et erreurs réseau explique comment ses robots traitent chacun d’eux.
| Contrôle | Pourquoi | Correction |
|---|---|---|
| Liens internes vers des pages en 404 | Liens morts pour les visiteurs et les robots | Corriger le lien, ou rediriger en 301 vers la page équivalente |
| Erreurs 5xx | Google ralentit l’exploration et retire de l’index les URL en erreur persistante | Voir avec l’hébergeur : ressources, extensions, cache |
| Erreurs 429 | Google les traite comme une erreur serveur | Ralentir le crawl, vérifier les protections anti-robots |
| Chaînes de redirections | Googlebot suit au maximum 10 redirections successives | Rediriger directement vers l’URL finale |
| Redirections 302 qui durent | La cible n’est pas traitée comme canonique | Passer en 301 si le changement est définitif |
| Liens internes vers des URL redirigées | Une redirection inutile à chaque visite | Remplacer par l’URL finale |
| Soft 404 | Page vide ou d’erreur qui renvoie un code 200 | Renvoyer un vrai 404 ou 410, ou étoffer la page |
| Plusieurs versions du site (http, https, www) | Le même contenu sous plusieurs adresses | Une seule version, les autres redirigées en 301 |
La différence entre 301 et 302 compte : d’après la page de Google sur les redirections, une redirection permanente (301 ou 308) indique que la cible doit devenir l’URL canonique, alors qu’une redirection temporaire (302 ou 307) ne le fait pas.
Balises canoniques et sitemap XML : aider Google à choisir les bonnes URL
Quand un même contenu est accessible par plusieurs URL (paramètres de tri, filtres, pages imprimables), Google en choisit une comme canonique. Sa documentation sur les URL en double classe la redirection 301 et la balise rel="canonical" parmi les signaux forts, le sitemap parmi les signaux faibles. Ce sont des signaux, pas des ordres : Google peut retenir une autre URL. À contrôler :
- chaque page indexable a une balise canonique qui pointe vers elle-même ou vers la version de référence ;
- la canonique pointe vers une URL qui répond en 200, ni redirigée ni en
noindex; - dans l’inspection d’URL, l’« URL canonique sélectionnée par Google » correspond à l’« URL canonique déclarée par l’utilisateur ».
Pour le sitemap XML, la documentation de Google sur les sitemaps fixe une limite de 50 000 URL ou 50 Mo non compressés par fichier et demande des URL absolues. Google ignore les champs priority et changefreq, mais tient compte de lastmod si la date est exacte. N’y mettez que des URL canoniques qui répondent en 200 : un sitemap rempli de redirections ou de pages en noindex envoie des signaux contradictoires.
Core Web Vitals : les seuils de vitesse à viser
Les Core Web Vitals mesurent trois aspects de l’expérience : le chargement, la réactivité et la stabilité de l’affichage. Voici les seuils d’un score « bon » publiés par Google :
Seuils mesurés au 75e centile des visites, sur mobile et sur ordinateur. Source : web.dev.
L’INP a remplacé le FID comme mesure de la réactivité : il est devenu une Core Web Vital stable en 2024. Pour l’audit, ouvrez le rapport Core Web Vitals de la Search Console, qui classe les URL par statut, puis testez chaque modèle de page concerné dans PageSpeed Insights : accueil, article, fiche produit.
Les causes à chercher en premier : images trop lourdes ou sans dimensions déclarées, polices et scripts tiers chargés trop tôt, temps de réponse du serveur. Sur WordPress, comparez les résultats avant et après la désactivation d’une extension pour trouver celle qui ralentit le site.
Version mobile et HTTPS : les contrôles d’expérience sur la page
Google explore et indexe la version mobile des sites, avec son robot smartphone. Sa documentation sur l’indexation mobile first demande que la version mobile ait le même contenu principal que la version ordinateur, les mêmes données structurées, ainsi qu’un title et une meta description équivalents. Elle déconseille aussi de charger le contenu principal seulement après un geste de l’utilisateur (clic, balayage), car Googlebot ne fait pas ces gestes.
Avec un thème responsive, le contenu est le même sur les deux supports : vérifiez surtout l’affichage de vos pages types sur un vrai téléphone. La page de Google sur l’expérience sur la page liste aussi ces points :
- des pages servies de façon sécurisée, en HTTPS ;
- pas d’interstitiel intrusif qui masque le contenu ;
- un contenu principal facile à distinguer du reste de la page, sans excès de publicités.
Dans Screaming Frog, l’onglet Protocol filtre les URL encore en http:// : vous repérez vite les liens internes oubliés lors du passage en HTTPS.
Données structurées : contrôler le balisage sans prendre de risque
Les données structurées aident Google à comprendre une page et peuvent lui ouvrir des résultats enrichis. Un balisage invalide ne donne droit à aucun résultat enrichi, pas plus qu’un balisage contraire aux règles de Google. Pour chaque modèle de page, passez une URL dans le Test des résultats enrichis, puis suivez les rapports de la Search Console consacrés aux données structurées, qui listent les erreurs sur tout le site.
Cas réel : l’audit de ce site, emmanuelmichel.fr, le 3 novembre 2026. L’indexation était saine (20 pages sur 20 indexées), mais une extension de données structurées ajoutait sur les 20 pages, CGV et contact compris, un bloc Organization avec une note de 5 sur 5. Or Google n’affiche pas d’étoiles quand l’entreprise contrôle les avis qui la concernent, d’après ses règles sur les extraits d’avis. Deux articles avaient en plus un schéma vidéo signalé comme invalide par la Search Console.
Sur WordPress, relisez donc ce que vos extensions de balisage ajoutent par défaut : ce code ne se voit pas à l’écran, et personne ne le contrôle tant qu’un rapport ne le signale pas.
Balises et maillage interne : les contrôles on-page du crawl
Le même crawl sert à contrôler les balises de chaque page et la structure des liens internes. Dans Screaming Frog, chaque contrôle a son onglet ou sa colonne :
| Contrôle | Où le voir dans Screaming Frog |
|---|---|
| Titles absents, en double ou trop longs | Onglet Page Titles |
| Meta descriptions absentes ou en double | Onglet Meta Description |
| H1 absent ou en plusieurs exemplaires | Onglet H1 |
| Images sans attribut alt | Onglet Images |
| Pages trop éloignées de l’accueil | Colonne Crawl Depth de l’onglet Internal |
| Pages orphelines, sans aucun lien interne | Crawl croisé avec le sitemap ou la Search Console |
Sur emmanuelmichel.fr, l’audit du 3 novembre 2026 avait relevé 5 titles de plus de 60 caractères et 12 meta descriptions reprises automatiquement du premier paragraphe, avec des phrases coupées. Les titles ou meta descriptions de 18 pages ont été réécrits le lendemain. La correction est un travail de rédaction, mais c’est le crawl qui a repéré le problème.
Prioriser les corrections après l’audit technique
Une liste d’alertes sans ordre ne sert pas à grand-chose. Classez chaque problème en trois niveaux :
- Les problèmes bloquants empêchent l’indexation de pages importantes (
noindexinvolontaire, robots.txt trop strict, erreurs 5xx, canonique erronée). À corriger tout de suite. - Les problèmes importants diluent ou ralentissent (chaînes de redirections, liens vers des 404, Core Web Vitals mauvais sur les pages qui reçoivent du trafic, balisage invalide).
- Les corrections de confort améliorent à la marge (attribut alt d’une image décorative, meta description un peu longue).
Croisez ensuite avec l’effort : une ligne de robots.txt se corrige en deux minutes, une refonte de thème prend des semaines. Commencez par ce qui a le plus d’impact pour le moins d’effort. Après chaque correction, le bouton « Valider la correction » des rapports de la Search Console demande à Google de revérifier les URL concernées.
Une checklist d’audit technique tient en six familles : indexation, exploration, codes HTTP, canoniques, expérience sur la page, balisage. Traitez-les dans cet ordre et corrigez d’abord ce qui bloque.
Questions fréquentes sur l’audit technique SEO
Qu’est-ce qu’un audit technique SEO ?
C’est l’examen de tout ce qui permet à Google d’explorer, d’afficher et d’indexer un site : accès des robots, codes de réponse, redirections, canoniques, vitesse, version mobile, balisage. Il se distingue de l’audit de contenu, qui juge la qualité des pages et leur adéquation aux recherches, et de l’audit de liens, qui porte sur la popularité.
Peut-on faire un audit technique SEO gratuitement ?
Oui pour un premier diagnostic : la Search Console, PageSpeed Insights et le Test des résultats enrichis sont gratuits, et Screaming Frog l’est jusqu’à 500 URL. Au-delà, la licence coûte 199 £ par an (tarif relevé en novembre 2026). Pour apprendre à mener ces contrôles en interne, une formation SEO pour votre équipe reprend la méthode sur votre propre site.
Combien coûte un audit technique SEO réalisé par un consultant ?
Le prix dépend du nombre de pages, de la technologie du site et du livrable attendu : une liste de corrections ou un suivi de leur mise en œuvre. J’établis un devis après un premier échange de 30 minutes en visio, offert.
À quel moment faire un audit technique ?
Avant et après une refonte ou une migration, après un changement de thème ou d’hébergeur, et dès qu’une baisse de trafic ne s’explique pas par le contenu. Entre deux audits, un coup d’œil mensuel aux rapports d’indexation et de Core Web Vitals de la Search Console aide à repérer un incident tôt.
Vous voulez un diagnostic complet de votre site ? En tant que consultant SEO à Lyon, je réalise des audits techniques SEO avec un plan de corrections classé par impact, et je peux suivre leur mise en œuvre dans le cadre d’un accompagnement SEO mensuel. Le premier échange de 30 minutes est offert.
Laisser un commentaire